# GLM-4.7 & GLM-4.6 & GLM-4.5
[中文阅读](./README_zh.md) | [English](./README.md)
👋 Discord コミュニティにご参加ください。
📖 GLM-4.7の 技術ブログ、技術レポート(GLM-4.5)、Zhipu AI技術ドキュメントをご覧ください。
📍 GLM-4.7 APIサービスをZ.ai APIプラットフォームでご利用いただけます。
👉 ワンクリックでGLM-4.7へ。
## モデル紹介
### GLM-4.7
**GLM-4.7** は、あなたの新しいコーディングパートナーとして、以下の機能を備えています:
- **コアコーディング能力**:GLM-4.7 は、前モデル GLM-4.6 と比較して、多言語エージェントコーディングおよびターミナルベースのタスクで明確な向上を実現しています。SWE-bench(73.8%、+5.8%)、SWE-bench Multilingual(66.7%、+12.9%)、Terminal Bench 2.0(41%、+16.5%)などで改善が見られます。GLM-4.7 は行動前の思考もサポートしており、Claude Code、Kilo Code、Cline、Roo Code などの主要なエージェントフレームワークでの複雑なタスクにおいて大幅な改善を実現しています。
- **バイブコーディング**:GLM-4.7 は UI 品質の向上において大きく前進しました。よりクリーンでモダンなウェブページを生成し、レイアウトとサイズがより正確で見栄えの良いスライドを作成できます。
- **ツール使用**:GLM-4.7 はツール使用能力において大幅な改善を達成しました。τ²-Bench などのベンチマークや、BrowseComp によるウェブブラウジングで著しく優れたパフォーマンスが見られます。
- **複雑な推理**:GLM-4.7 は数学および推理能力において大幅な向上を実現し、HLE(Humanity's Last Exam)ベンチマークで GLM-4.6 と比較して(42.8%、+12.4%)を達成しています。
より一般的には、チャット、クリエイティブライティング、ロールプレイシナリオなど、他の多くのシナリオでも大幅な改善が見られます。
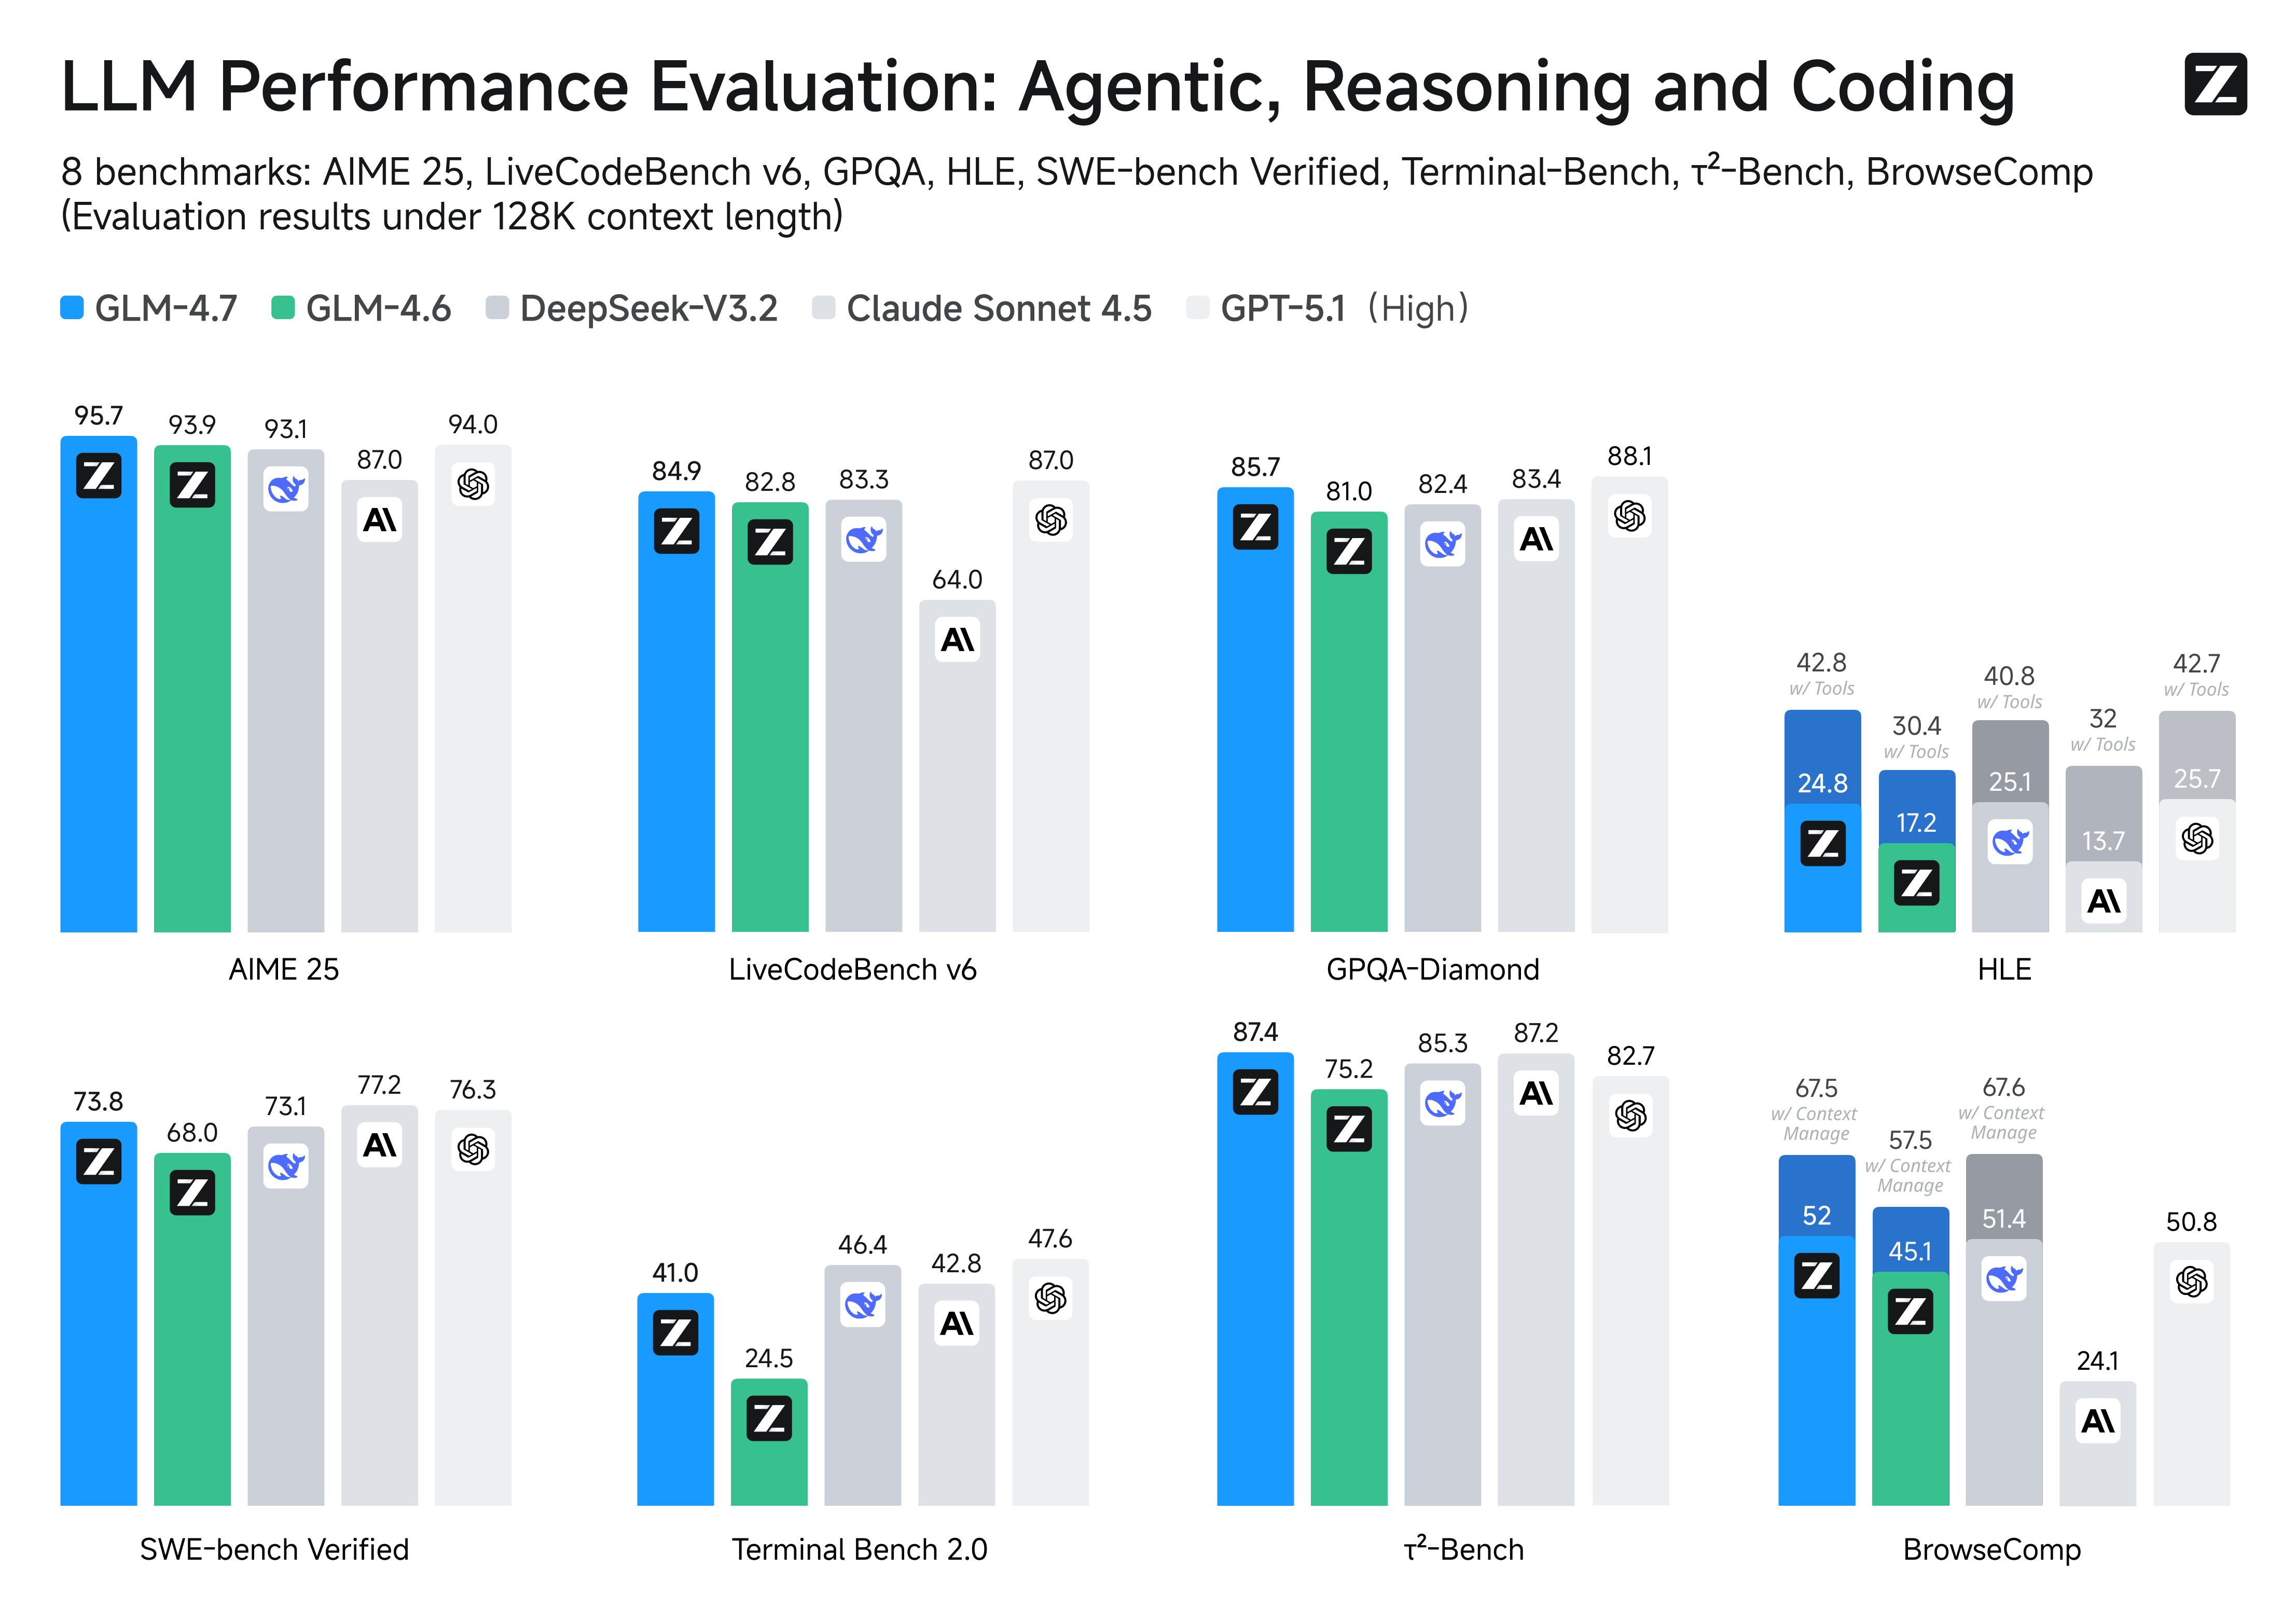
**インターリーブ思考と保持思考**
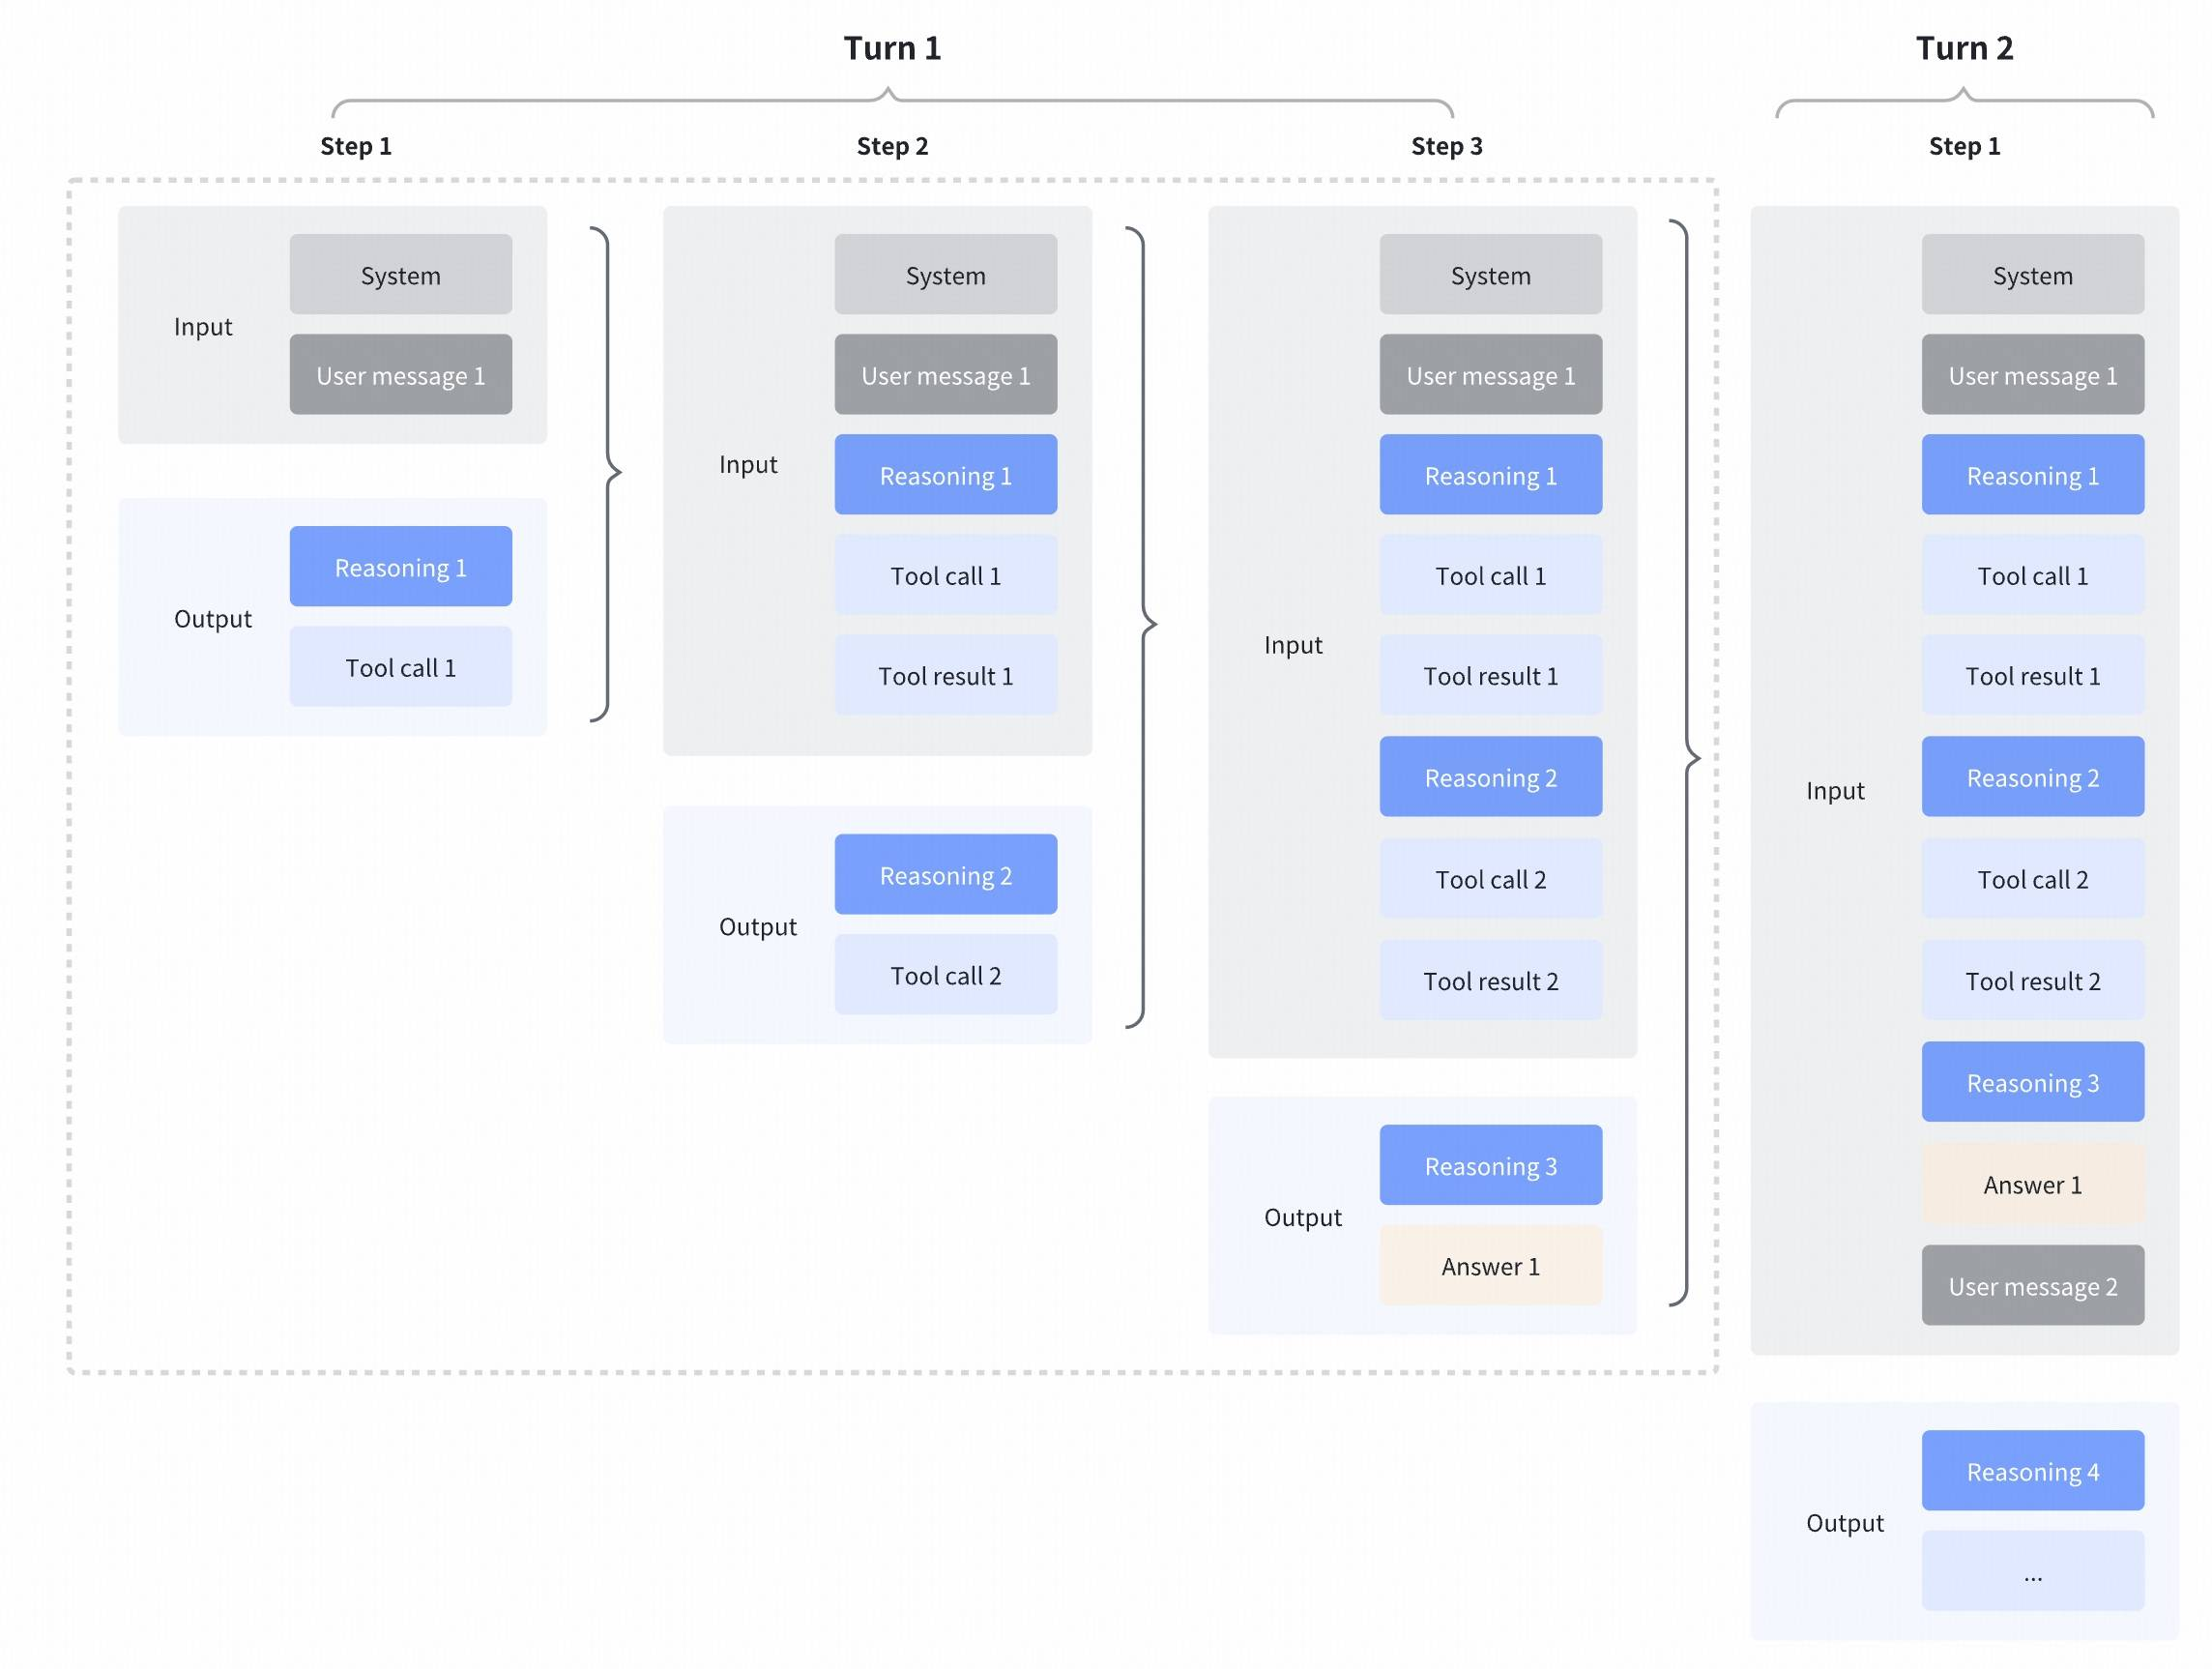
GLM-4.7 は**インターリーブ思考**(GLM-4.5 から導入された機能)をさらに強化し、**保持思考**と**ターンレベル思考**を導入しました。アクション間で思考し、ターン間で一貫性を保つことで、複雑なタスクをより安定的かつ制御可能にします:
- **インターリーブ思考**:モデルはすべての応答とツール呼び出しの前に思考し、指示への追従と生成品質を向上させます。
- **保持思考**:コーディングエージェントシナリオでは、モデルはマルチターン会話全体ですべての思考ブロックを自動的に保持し、ゼロから再導出するのではなく既存の推理を再利用します。これにより情報の損失と不整合が減少し、長期的で複雑なタスクに適しています。
- **ターンレベル思考**:モデルはセッション内でターンごとに推理を制御できます。軽量なリクエストでは思考を無効にしてレイテンシー/コストを削減し、複雑なタスクでは思考を有効にして精度と安定性を向上させることができます。
詳細:https://docs.z.ai/guides/capabilities/thinking-mode
また、軽量な 30B-A3B モデル「GLM-4.7-Flash」も提供しており、性能と効率のバランスを両立した軽量デプロイの新しい選択肢となります。
### GLM-4.6
GLM-4.5と比較して、**GLM-4.6**はいくつかの重要な改善をもたらします:
- **より長いコンテキストウィンドウ:** コンテキストウィンドウが128Kから200Kトークンに拡張され、より複雑なエージェントタスクを処理できるようになりました。
- **優れたコーディング性能:** コードベンチマークでより高いスコアを達成し、Claude Code、Cline、Roo Code、Kilo Codeなどのアプリケーションにおいて、視覚的に洗練されたフロントエンドページの生成を含む、より優れた実世界のパフォーマンスを示します。
- **高度な推論:** GLM-4.6は推論性能の明確な向上を示し、推論時のツール使用をサポートすることで、全体的な能力が強化されています。
- **より有能なエージェント:** GLM-4.6はツール使用と検索ベースのエージェントにおいてより強力な性能を発揮し、エージェントフレームワーク内でより効果的に統合されます。
- **洗練された文章:** スタイルと可読性において人間の好みにより適合し、ロールプレイングシナリオにおいてより自然に振る舞います。
私たちは、エージェント、推論、コーディングをカバーする8つの公開ベンチマークでGLM-4.6を評価しました。結果はGLM-4.5に対する明確な改善を示し、GLM-4.6は**DeepSeek-V3.1-Terminus**や**Claude Sonnet 4**などの国内外の主要モデルに対しても競争上の優位性を保持しています。
### GLM-4.5
**GLM-4.5**シリーズモデルは、インテリジェントエージェント向けに設計された基盤モデルです。GLM-4.5は総パラメータ数**355**億、アクティブパラメータ数**32**億を有し、GLM-4.5-Airはより軽量な設計で総パラメータ数**106**億、アクティブパラメータ数**12**億を採用しています。GLM-4.5モデルは、推論、コーディング、インテリジェントエージェント機能を統合し、インテリジェントエージェントアプリケーションの複雑な要求に応えます。
GLM-4.5とGLM-4.5-Airはどちらもハイブリッド推論モデルで、2つのモードを提供します:複雑な推論とツール使用のための思考モードと、即座の応答のための非思考モードです。
私たちは、GLM-4.5とGLM-4.5-Airの両方について、ベースモデル、ハイブリッド推論モデル、およびハイブリッド推論モデルのFP8版をオープンソース化しました。これらはMITオープンソースライセンスの下でリリースされ、商用利用および二次開発が可能です。
12の業界標準ベンチマークにわたる包括的な評価において、GLM-4.5は**63.2**というスコアで例外的な性能を達成し、すべてのプロプライエタリおよびオープンソースモデルの中で**第3位**にランクインしています。特に、GLM-4.5-Airは優れた効率性を維持しながら**59.8**という競争力のある結果を提供しています。
より多くの評価結果、ショーケース、技術詳細については、[技術レポート](https://arxiv.org/abs/2508.06471)。
## モデルのダウンロード
| モデル | ダウンロードリンク | モデルサイズ | 精度 |
|------------------|-----------------------------------------------------------------------------------------------------------------------------------------------|------------|-----------|
| GLM-4.7 | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.7)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.7) | 355B-A32B | BF16 |
| GLM-4.7-FP8 | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.7-FP8)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.7-FP8) | 355B-A32B | FP8 |
| GLM-4.7-Flash | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.7-Flash)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.7-Flash) | 30B-A3B | BF16 |
| GLM-4.6 | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.6)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.6) | 355B-A32B | BF16 |
| GLM-4.6-FP8 | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.6-FP8)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.6-FP8) | 355B-A32B | FP8 |
| GLM-4.5 | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.5)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.5) | 355B-A32B | BF16 |
| GLM-4.5-Air | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.5-Air)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.5-Air) | 106B-A12B | BF16 |
| GLM-4.5-FP8 | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.5-FP8)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.5-FP8) | 355B-A32B | FP8 |
| GLM-4.5-Air-FP8 | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.5-Air-FP8)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.5-Air-FP8) | 106B-A12B | FP8 |
| GLM-4.5-Base | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.5-Base)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.5-Base) | 355B-A32B | BF16 |
| GLM-4.5-Air-Base | [🤗 Hugging Face](https://huggingface.co/zai-org/GLM-4.5-Air-Base)
[🤖 ModelScope](https://modelscope.cn/models/ZhipuAI/GLM-4.5-Air-Base) | 106B-A12B | BF16 |
- GLM-4.5、GLM-4.6 および GLM-4.7 のモデルコード、ツールパーサー(tool parser)と推論パーサー(reasoning parser)は、[transformers](https://github.com/huggingface/transformers/tree/main/src/transformers/models/glm4_moe)、[vLLM](https://github.com/vllm-project/vllm/blob/main/vllm/model_executor/models/glm4_moe_mtp.py)、[SGLang](https://github.com/sgl-project/sglang/blob/main/python/sglang/srt/models/glm4_moe.py) の実装で確認できます。
- GLM-4.7-Flash のモデルコードは、[transformers](https://github.com/huggingface/transformers/tree/main/src/transformers/models/glm4_moe_lite)、[vLLM](https://github.com/vllm-project/vllm/blob/main/vllm/model_executor/models/glm4_moe_lite_mtp.py)、[SGLang](https://github.com/sgl-project/sglang/blob/main/python/sglang/srt/models/glm4_moe_lite.py) の実装で確認できます。
## システム要件
### 推論(NVIDIA GPU)
「フル機能」のモデル推論のための最小および推奨構成を提供します。以下の表のデータは次の条件に基づいています:
1. すべてのモデルはMTPレイヤーを使用し、競争力のある推論速度を確保するために`--speculative-num-steps 3 --speculative-eagle-topk 1 --speculative-num-draft-tokens 4`を指定しています。
2. `cpu-offload`パラメータは使用していません。
3. 推論バッチサイズは`8`を超えません。
4. すべてFP8推論をネイティブサポートするデバイスで実行され、重みとキャッシュの両方がFP8形式であることを保証します。
5. サーバーメモリは`1T`を超える必要があり、通常のモデルのロードと動作を保証します。
以下の表の構成でモデルを実行できます:
| モデル | 精度 | GPUタイプと数量 |
|---------------|-----------|----------------------|
| GLM-4.5 | BF16 | H100 x 16 |
| GLM-4.5 | FP8 | H100 x 8 |
| GLM-4.5-Air | BF16 | H100 x 4 |
| GLM-4.5-Air | FP8 | H100 x 2 |
| GLM-4.7-Flash | BF16 | H100 x 2 |
以下の表の構成では、モデルは完全な128Kコンテキスト長を利用できます:
| モデル | 精度 | GPUタイプと数量 |
|---------------|-----------|-----------|
| GLM-4.5 | BF16 | H100 x 32 |
| GLM-4.5 | FP8 | H100 x 16 |
| GLM-4.5-Air | BF16 | H100 x 8 |
| GLM-4.5-Air | FP8 | H100 x 4 |
| GLM-4.7-Flash | BF16 | H100 x 2 |
### その他のデバイス
- Ascend A3 デバイスで [xLLM](https://github.com/jd-opensource/xllm) を使用して高速推論を行う場合は、[Ascend NPU デプロイメントガイド](example/Ascend_NPU/README_zh.md) をご参照ください。
- AMD GPU で推論を実行する場合は、[AMD GPU デプロイメントガイド](example/AMD_GPU/README_zh.md) をご参照ください。
### ファインチューニング
以下の表の構成で[Llama Factory](https://github.com/hiyouga/LLaMA-Factory)を使用してコードを実行できます:
| モデル | GPUタイプと数量 | 戦略 | バッチサイズ(GPU毎) |
|-------------|--------------------|----------|----------------------|
| GLM-4.5 | H100 x 16 | Lora | 1 |
| GLM-4.5-Air | H100 x 4 | Lora | 1 |
以下の表の構成で[Swift](https://github.com/modelscope/ms-swift)を使用してコードを実行できます:
| モデル | GPUタイプと数量 | 戦略 | バッチサイズ(GPU毎) |
|-------------|--------------------|----------|----------------------|
| GLM-4.5 | H20 (96GiB) x 16 | Lora | 1 |
| GLM-4.5-Air | H20 (96GiB) x 4 | Lora | 1 |
| GLM-4.5 | H20 (96GiB) x 128 | SFT | 1 |
| GLM-4.5-Air | H20 (96GiB) x 32 | SFT | 1 |
| GLM-4.5 | H20 (96GiB) x 128 | RL | 1 |
| GLM-4.5-Air | H20 (96GiB) x 32 | RL | 1 |
## クイックスタート
`requirements.txt` に記載されている設定要件に従って、依存関係(sglang、vllmなど)をインストールしてください。
### transformers
`inference`フォルダの`trans_infer_cli.py`コードを参照してください。
### vLLM
```shell
vllm serve zai-org/GLM-4.7-FP8 \
--tensor-parallel-size 4 \
--speculative-config.method mtp \
--speculative-config.num_speculative_tokens 1 \
--tool-call-parser glm47 \
--reasoning-parser glm45 \
--enable-auto-tool-choice \
--served-model-name glm-4.7-fp8
```
### SGLang
```shell
python3 -m sglang.launch_server \
--model-path zai-org/GLM-4.7-FP8 \
--tp-size 8 \
--tool-call-parser glm47 \
--reasoning-parser glm45 \
--speculative-algorithm EAGLE \
--speculative-num-steps 3 \
--speculative-eagle-topk 1 \
--speculative-num-draft-tokens 4 \
--mem-fraction-static 0.8 \
--served-model-name glm-4.7-fp8 \
--host 0.0.0.0 \
--port 8000
```
- PD-Disaggregation
以下は、単一マシンの複数GPUを使用してPD-Disaggregationを実装するシンプルな方法で、PとDがそれぞれ4つのGPUを使用します。
```shell
python -m sglang.launch_server --model-path zai-org/GLM-4.5-Air --disaggregation-mode prefill --disaggregation-ib-device mlx5_0 --tp-size 4
python -m sglang.launch_server --model-path zai-org/GLM-4.5-Air --disaggregation-mode decode --port 30001 --disaggregation-ib-device mlx5_0 --tp-size 4 --base-gpu-id 4
python -m sglang_router.launch_router --pd-disaggregation --prefill http://127.0.0.1:30000 --decode http://127.0.0.1:30001 --host 0.0.0.0 --port 8000
```
### パラメータ説明
- GLM-4.7 の場合、`vLLM` と `SGLang` の両方で `--tool-call-parser` を `glm47` に設定する必要があります。
- GLM-4.7 のエージェントタスクの場合、以下の設定を追加して[思考保持モード](https://docs.z.ai/guides/capabilities/thinking-mode)を有効にしてください(sglang のみ対応):
```
"chat_template_kwargs": {
"enable_thinking": true,
"clear_thinking": false
}
```
- `vLLM`と`SGLang`を使用する場合、リクエストを送信する際にデフォルトで思考モードが有効になります。思考スイッチを無効にしたい場合は、`extra_body={"chat_template_kwargs": {"enable_thinking": False}}`パラメータを追加する必要があります。
- 両方ともツール呼び出しをサポートしています。呼び出しにはOpenAIスタイルのツール記述形式を使用してください。
- 具体的なコードについては、`inference`フォルダの`api_request.py`を参照してください。
### 評価
- ツール統合推論については、[このドキュメント](resources/glm_4.6_tir_guide.md)を参照してください。
- 検索ベンチマークについて、私たちは検索エージェントをサポートするために、思考モードでの検索ツール呼び出し用の特定のフォーマットを設計しました。詳細なテンプレートについては[こちら](resources/trajectory_search.json)を参照してください。
## 引用
私たちの研究があなたの研究に役立った場合は、以下の論文の引用をご検討ください:
```bibtex
@misc{5team2025glm45agenticreasoningcoding,
title={GLM-4.5: Agentic, Reasoning, and Coding (ARC) Foundation Models},
author={GLM Team and Aohan Zeng and Xin Lv and Qinkai Zheng and Zhenyu Hou and Bin Chen and Chengxing Xie and Cunxiang Wang and Da Yin and Hao Zeng and Jiajie Zhang and Kedong Wang and Lucen Zhong and Mingdao Liu and Rui Lu and Shulin Cao and Xiaohan Zhang and Xuancheng Huang and Yao Wei and Yean Cheng and Yifan An and Yilin Niu and Yuanhao Wen and Yushi Bai and Zhengxiao Du and Zihan Wang and Zilin Zhu and Bohan Zhang and Bosi Wen and Bowen Wu and Bowen Xu and Can Huang and Casey Zhao and Changpeng Cai and Chao Yu and Chen Li and Chendi Ge and Chenghua Huang and Chenhui Zhang and Chenxi Xu and Chenzheng Zhu and Chuang Li and Congfeng Yin and Daoyan Lin and Dayong Yang and Dazhi Jiang and Ding Ai and Erle Zhu and Fei Wang and Gengzheng Pan and Guo Wang and Hailong Sun and Haitao Li and Haiyang Li and Haiyi Hu and Hanyu Zhang and Hao Peng and Hao Tai and Haoke Zhang and Haoran Wang and Haoyu Yang and He Liu and He Zhao and Hongwei Liu and Hongxi Yan and Huan Liu and Huilong Chen and Ji Li and Jiajing Zhao and Jiamin Ren and Jian Jiao and Jiani Zhao and Jianyang Yan and Jiaqi Wang and Jiayi Gui and Jiayue Zhao and Jie Liu and Jijie Li and Jing Li and Jing Lu and Jingsen Wang and Jingwei Yuan and Jingxuan Li and Jingzhao Du and Jinhua Du and Jinxin Liu and Junkai Zhi and Junli Gao and Ke Wang and Lekang Yang and Liang Xu and Lin Fan and Lindong Wu and Lintao Ding and Lu Wang and Man Zhang and Minghao Li and Minghuan Xu and Mingming Zhao and Mingshu Zhai and Pengfan Du and Qian Dong and Shangde Lei and Shangqing Tu and Shangtong Yang and Shaoyou Lu and Shijie Li and Shuang Li and Shuang-Li and Shuxun Yang and Sibo Yi and Tianshu Yu and Wei Tian and Weihan Wang and Wenbo Yu and Weng Lam Tam and Wenjie Liang and Wentao Liu and Xiao Wang and Xiaohan Jia and Xiaotao Gu and Xiaoying Ling and Xin Wang and Xing Fan and Xingru Pan and Xinyuan Zhang and Xinze Zhang and Xiuqing Fu and Xunkai Zhang and Yabo Xu and Yandong Wu and Yida Lu and Yidong Wang and Yilin Zhou and Yiming Pan and Ying Zhang and Yingli Wang and Yingru Li and Yinpei Su and Yipeng Geng and Yitong Zhu and Yongkun Yang and Yuhang Li and Yuhao Wu and Yujiang Li and Yunan Liu and Yunqing Wang and Yuntao Li and Yuxuan Zhang and Zezhen Liu and Zhen Yang and Zhengda Zhou and Zhongpei Qiao and Zhuoer Feng and Zhuorui Liu and Zichen Zhang and Zihan Wang and Zijun Yao and Zikang Wang and Ziqiang Liu and Ziwei Chai and Zixuan Li and Zuodong Zhao and Wenguang Chen and Jidong Zhai and Bin Xu and Minlie Huang and Hongning Wang and Juanzi Li and Yuxiao Dong and Jie Tang},
year={2025},
eprint={2508.06471},
archivePrefix={arXiv},
primaryClass={cs.CL},
url={https://arxiv.org/abs/2508.06471},
}
```
